Pre-IPO 研究框架的估值输入敏感性研究:披露颗粒度、可比公司选择与折价区间对定价结论的传导(2026)
从披露颗粒度、可比公司锚定与折价区间三项输入出发,拆解 Pre-IPO 估值结论的敏感性传导路径,并给出敏感性分析的呈现方式与信息不对称风险披露框架。
⚠ 本文为方法论研究,不构成投资建议。投资有风险,请审慎决策。
核心结论:Pre-IPO 估值结论的敏感性主要来自披露颗粒度、可比公司锚定与折价区间这三项输入假设——任一输入变动都会沿「披露数据→假设→模型→区间结论」的链条传导,因此研究应给出区间与敏感性方向,而非单点定价。
#标的/业务线定义
本文研究对象是 Pre-IPO 研究框架中的估值输入敏感性,属于方法论层面的研究编译,不针对任何具体标的给出定价或交易判断。讨论边界包括:
- Pre-IPO 一级市场股权:未上市公司的老股转让、员工持股平台份额、Pre-IPO 轮融资等;
- 上市预期研究:IPO 发行窗口、估值锚定与信息披露环境(可参见站内《IPO 发行窗口研究:发行时机、估值锚定与 Pre-IPO 信息环境分析》);
- 相邻资产形态:代币化股票、RWA 等以「非传统股权敞口」形式出现的资产,其估值同样面临披露颗粒度与流动性折价问题。
需要说明的是,Pre-IPO 在本文中仅作为研究主题出现,不构成任何交易推荐或价格预测。
#关键机制与数据
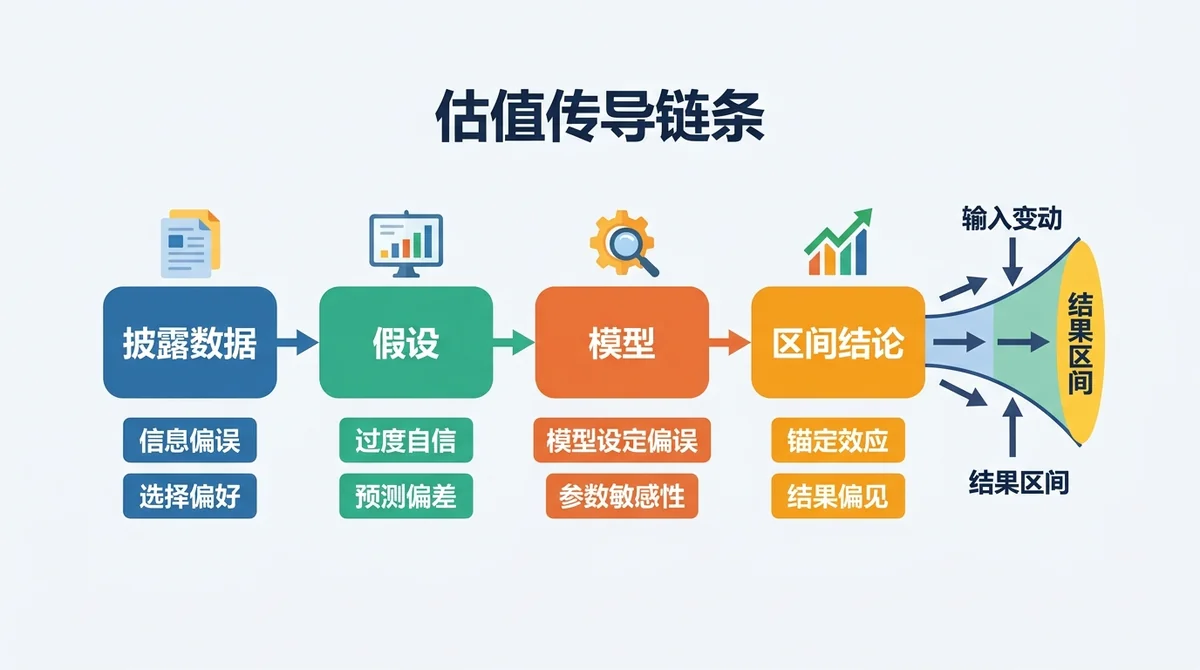
Pre-IPO 估值链条可以概括为四段:披露数据 → 假设 → 模型 → 区间结论。每一段都会引入偏差,且偏差会向后传导。
三项核心输入及其传导方式:
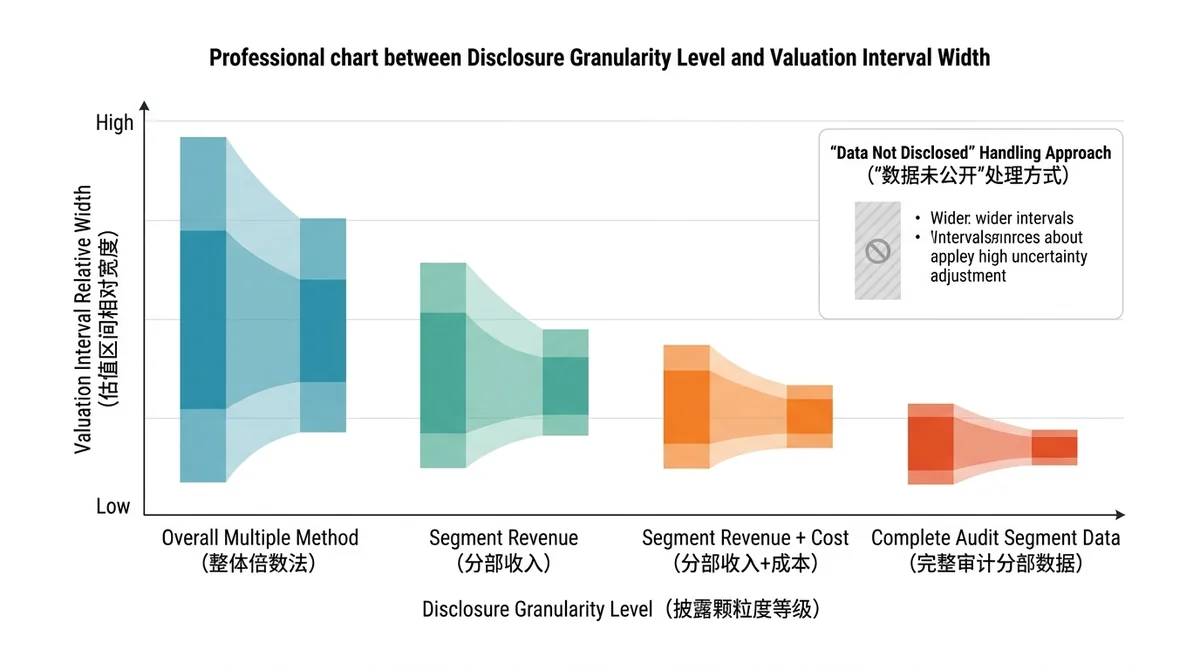
- 披露颗粒度:决定可拆分的估值变量数量。颗粒度粗时,研究者只能退回到整体收入倍数或整体 EV/Sales 法,模型自由度下降,区间被动变宽。
- 可比公司锚定:直接决定倍数中枢。同一标的在主口径与备选口径下,倍数中枢可能显著不同,从而改变整个区间的位置。
- 折价区间:对信息不对称、流动性缺失与退出不确定性的补偿。折价不是固定常数,其假设的变动会在终值上被放大。
数据提醒:本文为方法论研究,不引用具体标的的资金费率、溢价、营收、估值或认购倍数等数字;若后续研究涉及具体数字,均须标注「数据来自公开披露/行情,截至 XXXX-XX」。凡未公开披露的科目,一律标注「数据未公开」,不以假设替代事实。
#核心驱动力
驱动 Pre-IPO 估值结论敏感性的关键因素包括:
- 信息不对称程度:披露越不完整,假设替代事实的比例越高,结论可复现性越低;
- 可比集的稳定性:行业分类、收入结构、增长阶段、盈利状态与地域市场的差异,会使同一标的落入不同倍数区间;
- 退出路径清晰度:IPO 窗口、锁定期安排与二级流动性预期,直接影响折价假设的合理性;
- 披露口径的一致性:会计口径调整、分部数据补充或财务期间延长,都会改变输入变量的可比性。
#关键参与方
从研究框架角度看,Pre-IPO 估值链条涉及以下角色(仅列事实,不构成推荐):
- 发行人:披露材料的提供方,决定颗粒度上限;
- 承销与辅导机构:参与发行窗口选择与估值锚定沟通;
- 一级市场投资者:老股转让与 Pre-IPO 轮的定价参与者;
- 二级市场研究机构:在信息不对称条件下构建估值区间与敏感性框架;
- 相邻资产形态的发行方:代币化股票、RWA 等产品的估值同样受披露与流动性折价影响,可作方法论对照(可参见站内《代币化股票与基础美股套利机制研究:价差形成、执行成本与套利限制》与《房地产 RWA 现金流分配与流动性折价机制研究:产权碎片化、租金分配与赎回限制》)。
#风险与分歧
空方与审慎观点主要包括:
- Pre-IPO 估值本质上是在信息不完整条件下的估计,任何区间都带有方法论主观性,容易被误读为「定价结论」;
- 可比公司选择是主观性最强的环节,单一可比集容易产生锚定偏差,导致结论系统性偏高或偏低;
- 折价区间若套用固定折扣,会忽略披露质量与退出路径的差异,低估真实风险;
- 披露严重不足或口径无法核验时,给出估值区间本身可能构成误导,应明确说明「不给区间」。
信息不对称风险集中在三处:披露完整性、数据时效与管理层信息。研究结论必须标注假设来源、口径与不确定性等级。
#接下来关注什么
后续应重点跟踪三类变量,只列跟踪项与判断框架,不做方向性预测:
- 披露颗粒度变化:财务期间是否延长、分部数据是否补充、口径是否调整;
- 可比集变动:主口径与备选口径的构成是否发生变化,倍数中枢是否随之移动;
- 折价假设依据:流动性缺失与退出不确定性的补偿依据是否更新。
框架迭代原则:新披露优先替换旧假设,而非叠加假设。叠加假设会让模型越来越复杂,却不一定更接近事实。
#FAQ
见下方 FAQ 模块。
常见问题
Pre-IPO 估值结论为什么对输入假设如此敏感?
因为估值链条是「披露数据→假设→模型→区间结论」,每一环节都会引入偏差并向后传导。披露颗粒度、可比公司锚定与折价区间三项输入任一变动,都会改变最终区间,因此结论的敏感性主要来自输入假设而非模型本身。
披露颗粒度粗会带来哪些建模限制?
颗粒度决定可拆分的估值变量数量。粗颗粒度下研究者只能使用整体倍数法,模型自由度下降,估值区间应相应放宽,结论应更保守。关键科目缺失时应标注「数据未公开」,并说明其对区间宽度的影响。
为什么同一标的在不同框架下会得出不同区间?
主要因为可比公司选择与折价假设不同。可比公司锚定是主观性最强的环节,直接决定倍数中枢;折价区间则取决于对信息不对称、流动性缺失与退出不确定性的补偿判断。两者叠加,会使同一标的在不同框架下落入不同区间。
敏感性分析在 Pre-IPO 研究中应如何呈现?
应给出输入变动对结论区间的影响方向与幅度区间,而非单点结论。同时列示主口径与备选口径,标注假设来源、口径与不确定性等级,使读者能看清结论的分歧来源。
哪些情形下应拒绝给出估值区间?
当披露严重不足、口径无法核验或数据时效明显滞后时,应明确说明不给区间。用假设替代事实会制造虚假的精确性,反而放大信息不对称风险。
相关词条
想动手实操?可以在 MSX 平台用小仓位验证策略。本文仅为交易教育,不构成投资建议。